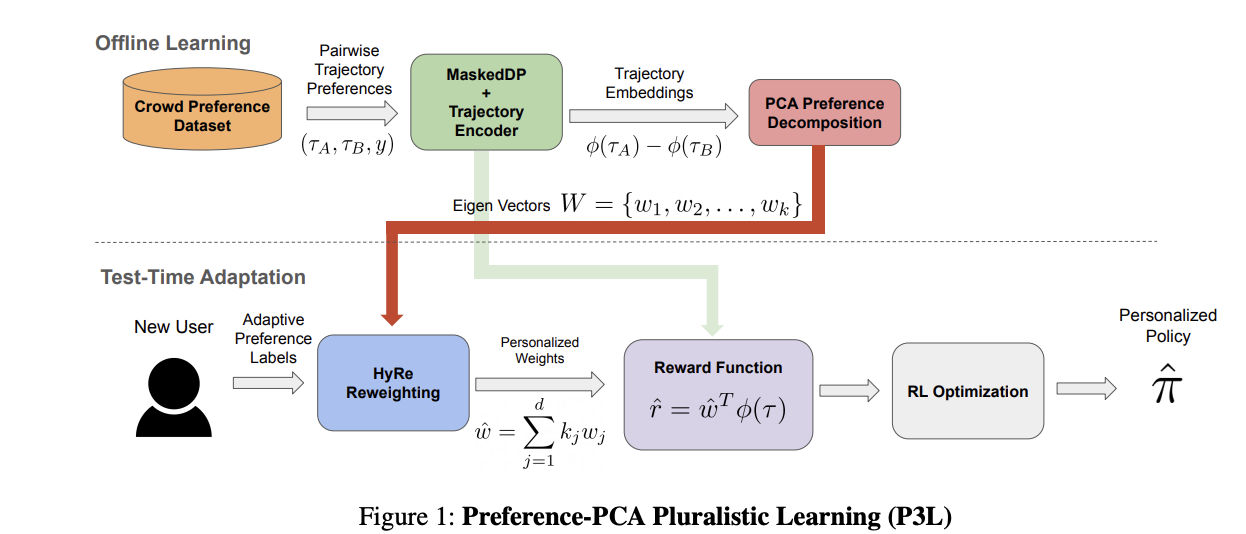
Steerable Pluralistic Policy Alignment from Anonymized Crowd Feedback.
Earlier version: “P3L: Learning Pluralistically Aligned Policies from Heterogeneous Crowd Feedback”, Reinforcement Learning Beyond Rewards (RLBrew) Workshop, RLC 2026.
Under Submission
TL;DR: We learn structured representations of heterogeneous preferences to support personalized reward functions and policies, including few-query adaptation when annotator identities are unavailable during training.